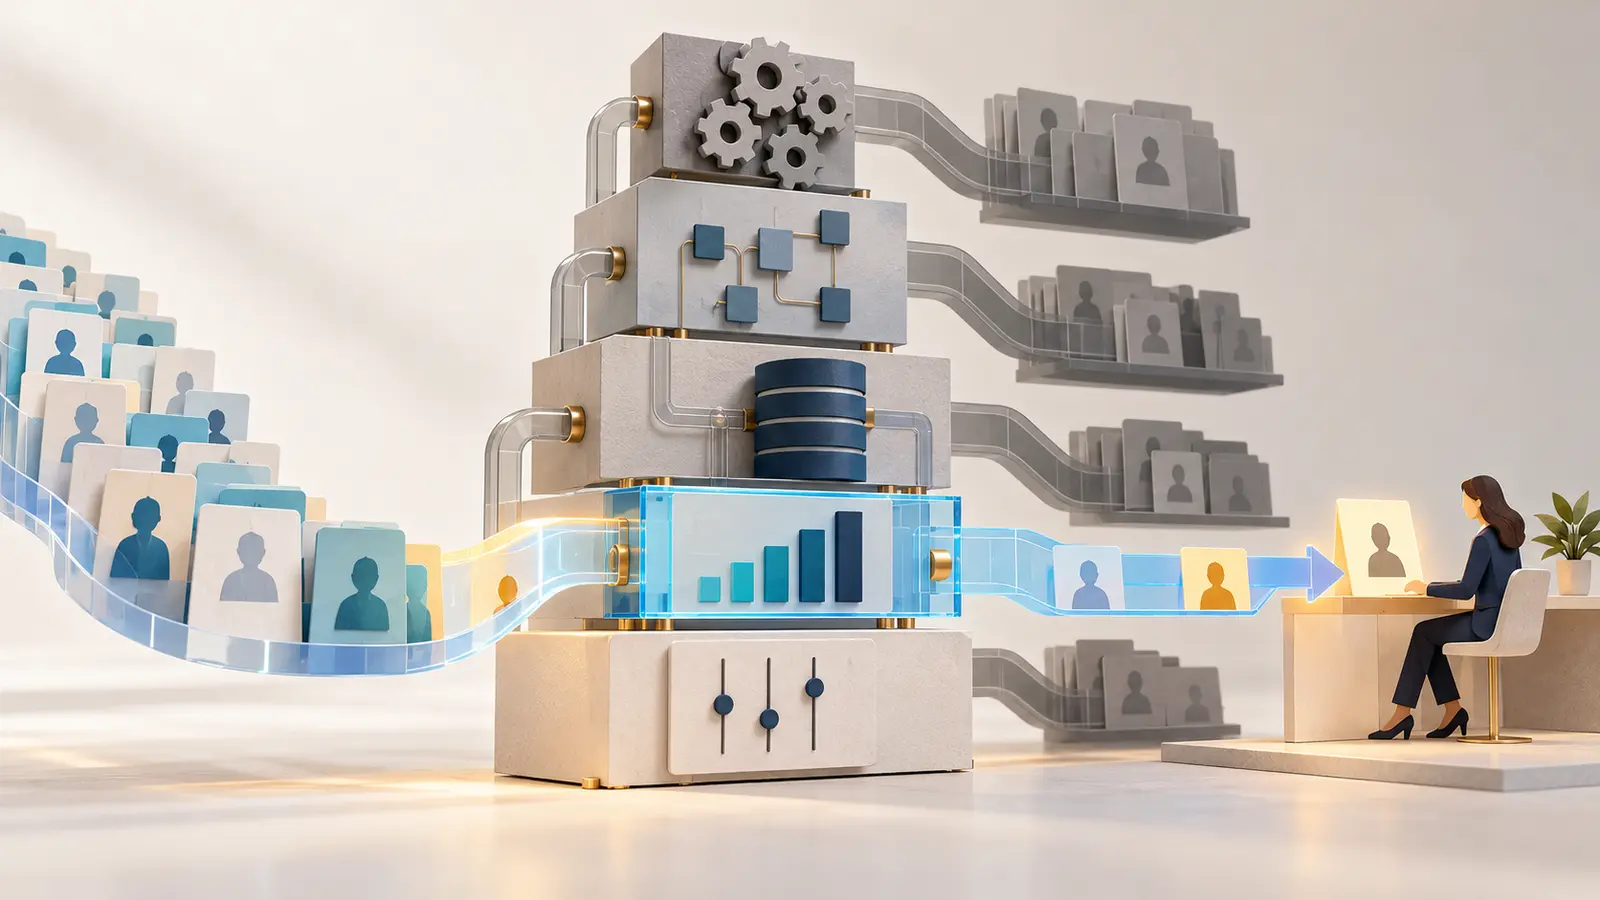
Resposta direta: a maioria das empresas de médio porte não deveria começar por um modelo próprio. Use regras transparentes quando o volume, o histórico ou a definição do resultado ainda são fracos. Use o scoring nativo do CRM quando dados, decisão, ação e feedback vivem principalmente na plataforma e o recurso entrega segmentação, explicação, integração e monitoramento suficientes. Construa um modelo próprio apenas quando uma decisão economicamente relevante depende de sinais de vários sistemas, o baseline nativo foi medido e limitado, e a empresa consegue operar histórico point-in-time, avaliação, logging, monitoramento, incidentes, retraining e rollback.
A pergunta não é qual algoritmo parece mais sofisticado. É qual arquitetura muda uma fila, abordagem, SLA, nurture ou orçamento com evidência melhor e custo operacional proporcional. Se vendas não sabe o que fazer com o score, o outcome é ambíguo ou o CRM não registra o resultado, trocar de modelo apenas automatiza uma decisão incompleta.
Comece pela decisão que o score controla
- Unidade — pessoa, conta, oportunidade ou outro objeto; não misture grãos.
- Outcome — aceitação, reunião realizada, oportunidade, pedido, receita ou margem, com janela de maturação.
- Ação — priorizar, rotear, nutrir, suprimir, pesquisar ou não agir.
- Capacidade — quantos registros o time consegue tratar dentro do SLA e com qual abordagem.
- Erro — custo de priorizar ruído, deixar demanda real para trás ou criar tratamento desigual.
- Comparador — fila atual, regra simples, score nativo ou política humana documentada.
- Feedback — quem devolve resultado e motivo, em quanto tempo e com que qualidade.
Um score sem ação definida vira decoração no CRM. O fluxo de qualificação e handoff em https://makinai.co/insights/pt/ia-qualificacao-passagem-leads-marketing-vendas ajuda a transformar ranking em trabalho comercial observável. Defina também quando o modelo deve se abster: evidência insuficiente pode pedir enriquecimento ou revisão, não um número com falsa precisão.
A Escada de Arquitetura do Lead Scoring
- Nível 0: reparar sem modelo — corrigir identidade, campos, lifecycle, labels, SLA e ownership antes de pontuar.
- Nível 1: regras e pesos — critérios explicáveis, decaimento, exclusões e faixas que a operação consegue revisar.
- Nível 2: scoring preditivo nativo do CRM — configuração, treino e score permanecem próximos dos objetos, workflows, listas e relatórios.
- Nível 3: modelo gerenciado externo em batch — warehouse ou serviço calcula scores, devolve valor, versão e razões ao CRM em cadência definida.
- Nível 4: serviço próprio de decisão — features point-in-time, endpoint, baixa latência, múltiplas ações, observabilidade, fallback e operação contínua.
Suba apenas quando o nível atual falhar em um requisito que gera valor. Regras são adequadas quando a política comercial importa mais que padrões sutis ou quando há poucos outcomes maduros. O nativo reduz integração e coloca o score onde usuários trabalham. O batch externo ganha flexibilidade sem assumir tempo real. Um serviço próprio faz sentido quando várias fontes e decisões reutilizam uma camada controlada e a latência realmente altera a ação.
Salesforce documenta modelos baseados no histórico de conversão, segmentação e fatores influentes. HubSpot permite escolher a transição de lifecycle e a janela de avaliação e publica um mínimo de amostra para gerar o score. Microsoft mostra scoring, razões e cadências diferentes para leads novos e existentes. Essas capacidades não provam adequação à sua economia; demonstram que o nativo já pode cobrir mais do que uma pontuação manual.
Passe por sete gates antes de construir
- Decisão e valor — a mudança potencial em pipeline, receita, margem ou capacidade justifica o projeto?
- Definição e maturação — outcome, janela, entidade e denominador permanecem estáveis o bastante para avaliação?
- Dados point-in-time — as features existiam no momento real, com cobertura, permissão e procedência conhecidas?
- Baseline — regra e recurso nativo foram configurados e comparados de forma justa?
- Ação e adoção — o score entra em workflow, fila e SLA; usuários entendem razões e devolvem feedback?
- Operação e risco — existem versão, logging, monitoramento, fallback, owner de incidente e rollback?
- Economia e saída — custo total, portabilidade, documentação e possibilidade de voltar ao nível anterior estão explícitos?
Se um gate falha, o próximo investimento costuma ser reparar o sistema, não construir o modelo. A evidência mínima em https://makinai.co/insights/pt/quanto-historico-dados-primeiro-workflow-ia-marketing ajuda a separar falta de histórico de falta de valor. A arquitetura histórica em https://makinai.co/insights/pt/feature-store-cdc-snapshots-arquitetura-historico-crm-ia mostra por que snapshots governados podem bastar antes de feature store, CDC ou serving em tempo real.
Compare custo total, não apenas licença ou treino
No scoring nativo, inclua licença, configuração, mapeamento de campos, limpeza, segmentação, workflows, treinamento de usuários, análise de erros, relatórios e operação. No modelo externo, adicione warehouse, transformação point-in-time, ambiente de desenvolvimento, avaliação, execução batch, integração de retorno, alertas e suporte. No serviço próprio, some endpoint, capacidade, segurança, observabilidade, incidentes, refresh, documentação, testes de regressão e cobertura de plantão.
O custo também depende do atraso do outcome, número de mercados e produtos, idiomas, entidades, volume, estabilidade do schema, frequência de score, explicações exigidas e impacto de um erro. Tempo real é caro quando muda apenas a velocidade do número, não a velocidade da ação. Customização é valiosa quando reduz uma limitação mensurável; não quando apenas replica um recurso nativo com outra interface.
Use três denominadores: custo por registro pontuado, custo por decisão realmente executada e custo por outcome incremental ou capacidade validamente poupada. O primeiro mede infraestrutura, o segundo expõe adoção, e o terceiro exige comparação causal ou pelo menos uma limitação de atribuição declarada.
Exemplo ilustrativo: três países, um único score
Imagine uma empresa B2B com 30 mil leads anuais, 800 oportunidades e vendas no Brasil, México e Estados Unidos. O CRM nativo consegue treinar um score sobre conversão em oportunidade, criar segmentos e exibir razões. Antes de financiar um modelo próprio, a equipe o compara com a fila atual e uma regra simples durante seis semanas. Descobre que a maior perda não está no ranking: o México registra resultados tarde e o Brasil mistura pedido de demonstração com download de conteúdo.
A decisão correta é permanecer no nível nativo, corrigir lifecycle e feedback e criar segmentos. Um modelo próprio só entra no backlog se, depois da correção, sinais de produto, faturamento ou intenção fora do CRM produzirem ganho consistente sobre outcomes maduros. O exemplo é deliberadamente ilustrativo; volume bruto não garante labels úteis nem viabilidade estatística.
Um piloto comparável de seis semanas
- Semana 1 — selecione uma decisão, um outcome maduro, população, janela, capacidade e política atual.
- Semana 2 — reconstrua uma amostra point-in-time; documente cobertura, desconhecidos, exclusões e atraso de feedback.
- Semana 3 — implemente ou corrija regra simples e scoring nativo com os mesmos dados e segmentos permitidos.
- Semana 4 — rode regra e nativo em sombra; revise ranking, calibração, razões, erros e impacto na fila.
- Semana 5 — faça uma prova externa apenas se houver limitação documentada; use a mesma janela, baseline e tratamento.
- Semana 6 — compare decisão executável, desempenho maduro, operação, risco e custo total; fique, repare, suba ou pare.
Entregáveis: contrato da decisão, inventário de dados, baseline, configuração nativa, dataset de avaliação, comparação por segmento, estimativa de TCO, log de riscos, plano de operação e registro da decisão. Não aceite uma demo em dados selecionados como prova de superioridade.
Responsabilidades, monitoramento e saída
Marketing define população, tratamento e resultado comercial. RevOps governa lifecycle, labels, capacidade e workflow. Vendas executa a ação e devolve motivo. Dados garante histórico, identidade, qualidade e replay. Ciência de dados avalia baseline, calibração e incerteza. Tecnologia opera integrações e serviço. Finanças valida custo e valor; compliance revisa atributos, explicação e impacto por grupo.
Um modelo próprio herda obrigações que a plataforma absorvia. O Google Cloud explicita schema, baseline, objetivos, thresholds e alertas no monitoramento. O NIST recomenda medir ao longo do ciclo e documentar incerteza, feedback e falhas. O artigo de drift em https://makinai.co/insights/pt/lead-score-ia-drift-modelo-qualidade-pipeline detalha o contrato operacional depois da escolha; essa operação deve entrar no business case antes do build.
Defina saída desde o início: exportar scores, versões, configurações, datasets permitidos, avaliação, documentação e histórico de decisões; desativar o serviço sem quebrar o CRM; e voltar para regra ou score nativo. Se sua empresa está decidindo entre configurar o CRM e financiar uma camada própria, leve à MAKINAI, em https://makinai.co/services/pt/consultoria-crm-ecommerce-commerce, uma decisão, um export de campos e outcomes e o workflow atual. Podemos delimitar a menor arquitetura que merece teste.
As fontes descrevem recursos e práticas de produto; não demonstram que uma opção vencerá na sua empresa. A Escada, os gates, custos, exemplo e piloto são recomendações editoriais da MAKINAI para validar com dados, operação e resultados maduros.