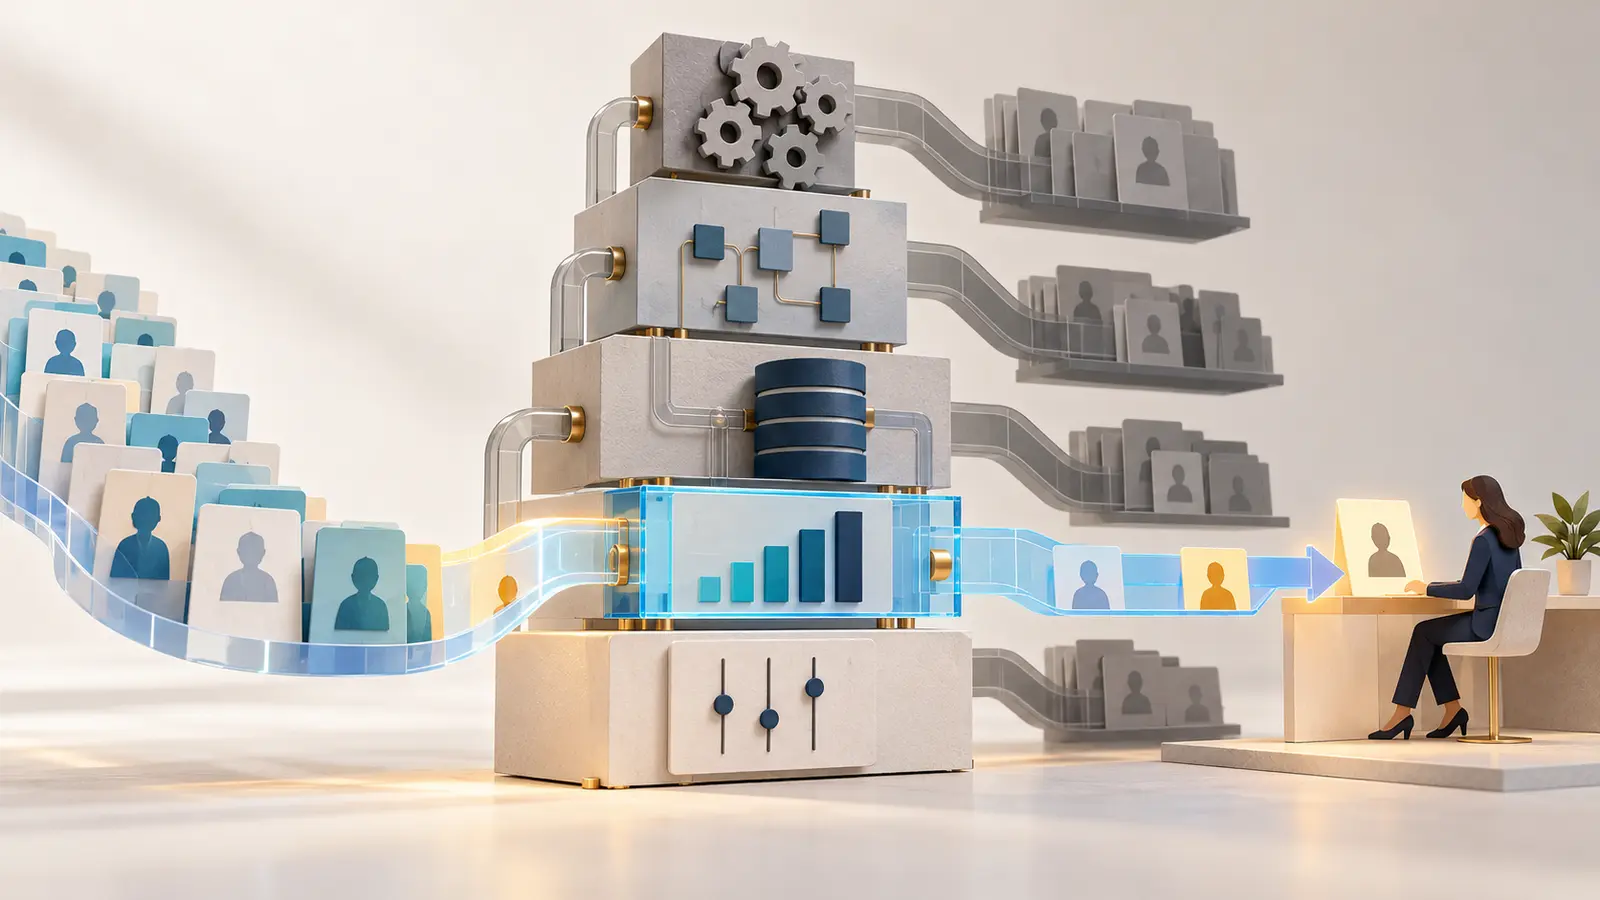
Respuesta directa: la mayoría de las empresas medianas no debería empezar por un modelo propio. Use reglas transparentes cuando volumen, historial o definición del resultado son débiles. Use scoring nativo cuando datos, decisión, acción y feedback viven principalmente en el CRM y la función ofrece segmentación, explicación, integración y monitoreo suficientes. Construya un modelo propio solo cuando una decisión relevante dependa de señales de varios sistemas, el baseline nativo tenga una limitación medida y la empresa pueda operar historia point-in-time, evaluación, logging, monitoreo, incidentes, reentrenamiento y rollback.
La pregunta no es qué algoritmo parece más sofisticado. Es qué arquitectura mejora una cola, abordaje, SLA, nurture o presupuesto con mejor evidencia y costo operativo proporcional. Si ventas no sabe qué hacer con el score, el outcome es ambiguo o el CRM no registra el resultado, cambiar de modelo solo automatiza una decisión incompleta.
Empiece por la decisión que controla el score
- Unidad — persona, cuenta, oportunidad u otro objeto; no mezcle granos.
- Outcome — aceptación, reunión realizada, oportunidad, pedido, ingreso o margen con ventana de maduración.
- Acción — priorizar, asignar, nutrir, suprimir, investigar o no actuar.
- Capacidad — cuántos registros puede atender el equipo dentro del SLA y con qué tratamiento.
- Error — costo de priorizar ruido, omitir demanda real o generar trato desigual.
- Comparador — cola actual, regla simple, score nativo o política humana documentada.
- Feedback — quién devuelve resultado y motivo, con qué demora y calidad.
Un score sin acción definida se vuelve decoración del CRM. El flujo de calificación y handoff en https://makinai.co/insights/es/ia-calificacion-leads-paso-marketing-ventas convierte ranking en trabajo comercial observable. Defina también abstención: evidencia insuficiente puede requerir enriquecimiento o revisión, no un número con precisión falsa.
La Escalera de Arquitectura del Lead Scoring
- Nivel 0: reparar sin modelo — corregir identidad, campos, lifecycle, labels, SLA y ownership antes de puntuar.
- Nivel 1: reglas y pesos — criterios explicables, decay, exclusiones y bandas que la operación puede revisar.
- Nivel 2: scoring predictivo nativo — configuración, entrenamiento y score cerca de objetos, workflows, listas y reportes del CRM.
- Nivel 3: modelo externo gestionado en batch — warehouse o servicio calcula scores y devuelve valor, versión y razones al CRM con cadencia definida.
- Nivel 4: servicio propio de decisión — features point-in-time, endpoint, baja latencia, varias acciones, observabilidad, fallback y operación continua.
Suba solo cuando el nivel actual falle en un requisito que crea valor. Las reglas sirven cuando la política comercial importa más que patrones sutiles o hay pocos outcomes maduros. Lo nativo reduce integración y lleva el score al lugar de trabajo. El batch externo agrega flexibilidad sin asumir tiempo real. Un servicio propio se justifica cuando varias fuentes y decisiones reutilizan una capa gobernada y la latencia cambia la acción.
Salesforce documenta modelos basados en conversiones, segmentación y factores influyentes. HubSpot permite elegir transición de lifecycle y ventana de evaluación y publica un mínimo de muestra. Microsoft muestra score, razones y diferencias de actualización para leads nuevos y registros existentes. Esas funciones no prueban ajuste económico, pero muestran que lo nativo puede cubrir bastante más que un sistema manual de puntos.
Pase siete gates antes de construir
- Decisión y valor — ¿el cambio potencial en pipeline, ingreso, margen o capacidad justifica el proyecto?
- Definición y maduración — ¿outcome, ventana, entidad y denominador son estables para evaluar?
- Datos point-in-time — ¿las variables existían al decidir, con cobertura, permiso y procedencia conocidos?
- Baseline — ¿regla y función nativa fueron configuradas y comparadas justamente?
- Acción y adopción — ¿el score entra en workflow, cola y SLA; usuarios entienden razones y devuelven feedback?
- Operación y riesgo — ¿hay versión, logging, monitoreo, fallback, owner de incidentes y rollback?
- Economía y salida — ¿costo total, portabilidad, documentación y vuelta al nivel anterior están explícitos?
Cuando falla un gate, la próxima inversión suele ser reparar el sistema, no construir el modelo. La evidencia mínima en https://makinai.co/insights/es/cuantos-datos-historicos-primer-workflow-ia-marketing separa falta de historial de falta de valor. La arquitectura histórica en https://makinai.co/insights/es/feature-store-cdc-snapshots-arquitectura-minima-historial-crm-ia explica por qué snapshots gobernados pueden bastar antes de feature store, CDC o serving online.
Compare costo total, no solo licencia o entrenamiento
Para scoring nativo incluya licencia, configuración, mapeo, limpieza, segmentación, workflows, capacitación, revisión de errores, reportes y operación. Para modelo externo agregue warehouse, transformaciones point-in-time, entorno de desarrollo, evaluación, ejecución batch, integración de retorno, alertas y soporte. Para servicio propio sume endpoints, capacidad, seguridad, observabilidad, incidentes, refresh, documentación, regresión y guardia.
El costo depende también de demora del outcome, países y productos, idiomas, entidades, volumen, estabilidad del schema, frecuencia, explicaciones y daño de un error. Tiempo real es caro cuando solo acelera el número, no la acción. La personalización crea valor cuando elimina una limitación medida, no cuando replica una función nativa detrás de otra interfaz.
Use tres denominadores: costo por registro puntuado, costo por decisión ejecutada y costo por outcome incremental o capacidad reasignada válidamente. El primero mide infraestructura, el segundo expone adopción y el tercero requiere comparación creíble o limitación explícita de atribución.
Ejemplo ilustrativo: tres países, un score
Imagine una empresa B2B con 30 mil leads anuales, 800 oportunidades y ventas en México, Colombia y Estados Unidos. El CRM nativo puede entrenar sobre conversión a oportunidad, crear segmentos y mostrar razones. Antes de financiar un modelo propio, el equipo lo compara seis semanas con la cola actual y una regla simple. La mayor pérdida no está en el ranking: Colombia registra outcomes tarde y México mezcla solicitudes de demo con descargas de contenido.
La decisión correcta es seguir con lo nativo, reparar lifecycle y feedback y segmentar la población. El modelo propio entra al backlog solo si señales de producto, facturación o intención fuera del CRM generan ganancia estable sobre outcomes maduros después de la corrección. El ejemplo es ilustrativo; volumen bruto no garantiza labels útiles ni viabilidad estadística.
Piloto comparable de seis semanas
- Semana 1 — elegir decisión, outcome maduro, población, ventana, capacidad y política actual.
- Semana 2 — reconstruir muestra point-in-time; documentar cobertura, desconocidos, exclusiones y demora del feedback.
- Semana 3 — implementar o corregir regla simple y score nativo con los mismos datos y segmentos permitidos.
- Semana 4 — ejecutar regla y nativo en sombra; revisar ranking, calibración, razones, errores e impacto en la cola.
- Semana 5 — probar enfoque externo solo si existe una limitación documentada; conservar ventana, baseline y tratamiento.
- Semana 6 — comparar decisión ejecutable, desempeño maduro, operación, riesgo y costo total; seguir, reparar, subir o parar.
Entregables: contrato de decisión, inventario de datos, baseline, configuración nativa, dataset de evaluación, comparación por segmento, TCO, riesgos, plan operativo y registro de decisión. No acepte una demo con datos seleccionados como prueba de superioridad.
Responsables, monitoreo y salida
Marketing define población, tratamiento y resultado. RevOps gobierna lifecycle, labels, capacidad y workflow. Ventas ejecuta la acción y devuelve motivo. Datos asegura historia, identidad, calidad y replay. Ciencia de datos evalúa baseline, calibración e incertidumbre. Tecnología opera integración y servicio. Finanzas valida costo y valor; compliance revisa atributos, explicación e impacto por grupo.
Un modelo propio hereda obligaciones antes absorbidas por la plataforma. Google Cloud explicita schema, baseline, objetivos, thresholds y alertas en monitoreo. NIST recomienda medir durante el ciclo y documentar incertidumbre, feedback y fallas. La guía de deriva en https://makinai.co/insights/es/lead-scoring-ia-deriva-modelo-calidad-pipeline detalla la operación después de elegir; ese costo debe entrar al business case antes del build.
Defina salida desde el inicio: exportar scores, versiones, configuración, datasets permitidos, evaluaciones, documentación e historial de decisiones; apagar el servicio sin romper el CRM; y volver a regla o score nativo. Si su empresa decide entre configurar el CRM y financiar una capa propia, lleve a MAKINAI, en https://makinai.co/services/es/consultoria-crm-ecommerce-commerce, una decisión, un export de campos y outcomes y el workflow actual. Podemos delimitar la menor arquitectura que merece prueba.
Las fuentes documentan funciones y prácticas; no prueban que una opción vencerá en su empresa. La Escalera, gates, costos, ejemplo y piloto son recomendaciones editoriales de MAKINAI para validar con datos, operación y resultados maduros.