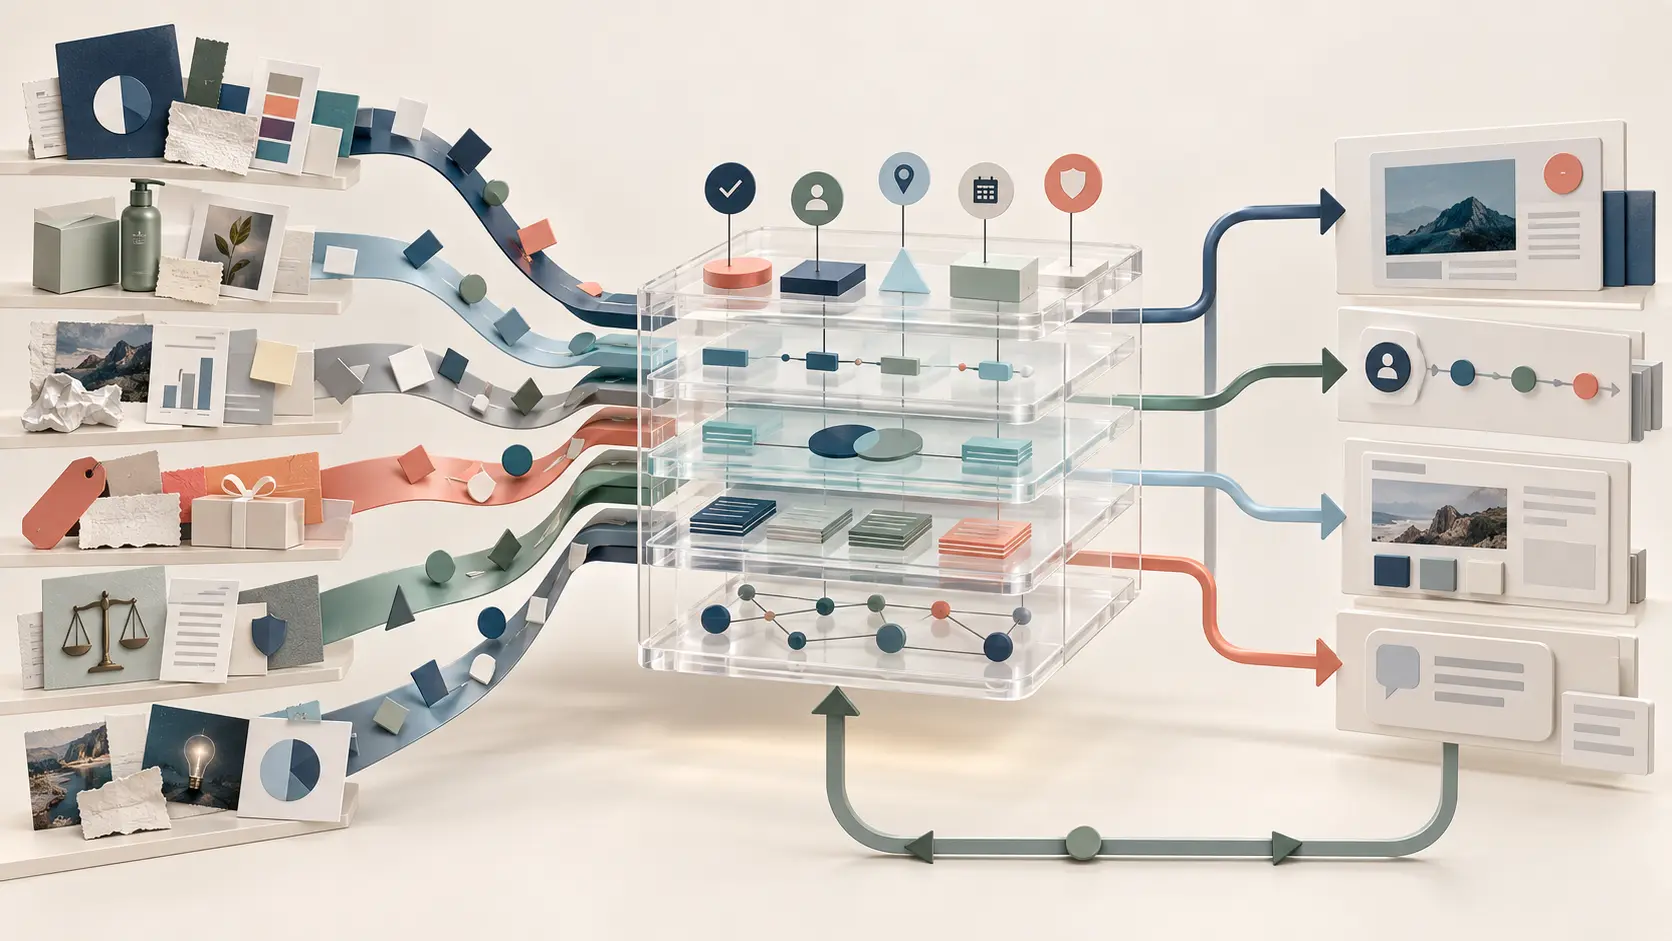
Se dois copilotos dão respostas diferentes sobre o mesmo produto, o primeiro investimento não deveria ser outra licença. Implemente uma camada de conhecimento do marketing: um conjunto governado de fatos, claims, ofertas, evidências, regras de canal e aprendizados, cada item com fonte, responsável, mercado, validade e uso permitido. Depois conecte um único fluxo de alto valor — por exemplo, briefing e produção de campanha — e meça se a equipe chega mais rápido a uma saída aprovada, com menos correções factuais.
Uma camada de conhecimento não é simplesmente uma pasta, um chatbot sobre PDFs ou um novo DAM. Ela separa o que é autoridade do que é rascunho, resolve versões conflitantes, limita a recuperação por mercado e data, mostra a fonte usada e cria um caminho para corrigir a informação. A tecnologia de RAG ajuda a localizar contexto; não decide qual claim é válido, quem pode aprová-lo nem quando deve expirar.
Por que mais ferramentas podem aumentar o retrabalho
Marketing costuma guardar partes da verdade em apresentações de marca, páginas de produto, e-mails comerciais, contratos de campanha, CMS, CRM, PIM, DAM e conversas com agências. Um copiloto encontra um preço antigo; outro resume uma proposta já substituída; a equipe local traduz uma promessa que só foi aprovada para outro país. O modelo parece inconsistente porque o sistema de conhecimento é inconsistente.
O problema aparece no fim como copy errada ou demora de aprovação, mas nasce antes: não há hierarquia entre fontes, owner do fato, data de vigência nem regra de mercado. Pedir ao modelo para 'usar apenas informação correta' não cria esses campos. Uma implantação útil trata conhecimento como parte da operação, não como material anexado ao prompt.
Contrato de Conhecimento de Marketing: nove campos mínimos
- Unidade — um fato, claim, oferta, prova, regra ou decisão que pode ser reutilizada sem perder contexto.
- Fonte de autoridade — sistema, documento ou pessoa que confirma a informação.
- Owner — quem responde pela validade e aprova alteração.
- Mercado e idioma — onde a informação pode ser usada e qual versão é primária.
- Vigência — início, expiração ou condição que exige revisão.
- Evidência — pesquisa, política, especificação, contrato ou dado que sustenta a afirmação.
- Uso permitido — canais, públicos, formatos e limites; inclui proibições explícitas.
- Dependências — produto, preço, disponibilidade, direitos, consentimento ou aprovação jurídica.
- Rastro — versão, derivação, ativos publicados que usaram o item e caminho de correção.
Esse contrato pode começar como um schema pequeno sobre as fontes existentes. Não exige consolidar todo o conteúdo corporativo nem comprar uma plataforma nova. O W3C mantém um modelo interoperável de proveniência que relaciona entidades, atividades e agentes; ele é uma referência útil para pensar em origem e derivação, mas o projeto deve adotar apenas a granularidade necessária para operar.
Escolha um fluxo, não toda a base da empresa
Comece por uma família recorrente de campanha, um produto e um mercado. Liste as perguntas que mais causam ida e volta: qual benefício pode ser prometido, que prova sustenta o claim, qual oferta vale agora, que termo é obrigatório e que adaptação local é permitida. Um recorte pequeno permite encontrar conflitos reais, testar owners e provar integração antes de escalar.
Para informação estruturada e determinística — preço atual, estoque, elegibilidade ou data — prefira API, regra ou banco transacional. Use recuperação semântica para conteúdo não estruturado, como orientações de marca, pesquisas, playbooks e evidências. Use geração para sintetizar ou adaptar dentro dos limites recuperados. Misturar tudo em uma base vetorial transforma respostas exatas em aproximações desnecessárias.
O fluxo da fonte até a saída aprovada
- 1. Inventariar — mapear fontes, versões, acessos, donos e conflitos do fluxo escolhido.
- 2. Resolver autoridade — definir qual fonte vence, quem decide exceções e quando revisar.
- 3. Estruturar — converter conteúdo em unidades do contrato, preservando documento original e ligação de proveniência.
- 4. Recuperar — indexar o necessário e filtrar por produto, mercado, idioma, vigência, permissão e tipo de uso.
- 5. Responder ou abster — exigir citação interna e recusar quando a fonte falta, conflita ou expirou.
- 6. Aprovar e publicar — apresentar ao revisor saída, fonte, transformação e risco; registrar a decisão.
- 7. Aprender — devolver correções, perguntas sem resposta e resultado do ativo ao backlog de conhecimento.
A documentação da OpenAI mostra que arquivos em uma base vetorial podem ser fragmentados, transformados em embeddings, indexados e filtrados por atributos. O Google descreve etapas equivalentes de ingestão, transformação, indexação, recuperação e geração. Isso confirma que o encanamento existe em diferentes plataformas. A parte difícil — autoridade, metadados, avaliação e rotina de atualização — continua sendo trabalho de implementação.
Teste a camada com perguntas que podem falhar
Crie um conjunto de avaliação antes de ligar o copiloto ao trabalho real. Inclua perguntas simples, conflitos entre versões, fonte expirada, mercados diferentes, claim sem evidência, instrução para ignorar política e questão legítima ainda sem resposta. Para cada caso, registre a fonte esperada, resposta aceitável, motivo para abstenção e revisor competente. Trocar o modelo sem repetir esse conjunto impede saber se a mudança melhorou o sistema.
- Recuperação — a fonte correta apareceu entre os resultados e a versão errada ficou fora?
- Fundamentação — cada afirmação material está apoiada pela fonte exibida?
- Abstenção — o sistema para quando falta evidência, permissão ou vigência?
- Consistência — perguntas equivalentes recebem a mesma regra em canais e idiomas apropriados?
- Operação — correções chegam às saídas dependentes e o owner consegue auditar o histórico?
NIST recomenda tratar avaliação e monitoramento ao longo do ciclo de vida da IA generativa. Neste projeto, isso significa testar antes do uso, observar falhas em produção, registrar mudanças de fonte e manter uma forma de interromper o fluxo. Um teste bonito com cinco perguntas não demonstra operação confiável.
Um escopo contratável de oito semanas
- Semanas 1–2: escolher fluxo, produto e mercado; medir baseline; inventariar fontes, conflitos, owners e acessos.
- Semanas 3–4: definir o contrato de conhecimento, hierarquia de autoridade, vigência, permissões, ingestão e política de exclusão.
- Semanas 5–6: integrar uma interface de trabalho, operar em modo sombra e executar o conjunto de avaliação e casos adversos.
- Semanas 7–8: liberar um uso delimitado, medir qualidade e tempo, corrigir propagação, documentar operação e decidir ampliar, ajustar ou encerrar.
A entrega deve incluir mapa de fontes, schema, conteúdo priorizado, regras de autoridade, conectores, índice e filtros, conjunto de avaliação, logs, painel, runbook, fila de exceções e plano de manutenção. Oito semanas delimitam um primeiro fluxo; não garantem limpar o conhecimento de toda a empresa nem eliminar erros do modelo.
O que realmente muda custo e arquitetura
O investimento cresce com número de fontes, formatos, produtos, marcas, países e idiomas; qualidade de metadados; frequência de mudança; permissões por função; conectores; necessidade de OCR; volume de uso; modelo e infraestrutura; avaliação humana; requisitos de privacidade; e quantidade de sistemas que precisam receber correções. A licença do copiloto é apenas uma linha.
Centralizar tudo simplifica descoberta, mas amplia migração e governança. Consultar fontes no lugar reduz cópia, porém depende de disponibilidade e APIs. RAG gerenciado acelera o piloto e cria dependência de plataforma; uma camada própria aumenta portabilidade e custo operacional. Um grafo de conhecimento pode explicitar relações complexas, mas costuma ser excesso para o primeiro fluxo. Escolha a menor arquitetura que preserve autoridade, filtros, rastro e avaliação.
Meça capacidade e resultado sem confundir os dois
- Qualidade — fonte correta, claim sustentado, conflito detectado, abstenção adequada e erro por classe.
- Operação — tempo até aprovação, horas de revisão, retrabalho, idade da fonte e tempo para propagar uma correção.
- Adoção útil — tarefas reais concluídas com a camada e saídas aprovadas e efetivamente utilizadas, não apenas logins.
- Negócio — tempo de campanha, custo por ativo usado, conversão ou receita do fluxo escolhido, com baseline e comparação compatíveis.
Se a camada melhora a resposta, mas a aprovação continua parada ou o ativo não chega ao canal, o gargalo está fora dela. Se o ciclo acelera e o resultado comercial não muda, revise proposta, distribuição ou mensuração antes de ampliar. Atribua resultado ao fluxo completo, não ao modelo isolado.
Quem responde pela implementação
Marketing define os casos, padrão de qualidade e resultado. Produto, vendas e especialistas respondem pelos fatos. Jurídico e privacidade definem limites quando aplicável. Conteúdo e marca mantêm linguagem e evidências. Tecnologia cuida de identidade, conectores, acesso, recuperação e observabilidade. A agência ou consultoria deve ligar essas partes, implementar um fluxo real e deixar owners e operação claros; não pode entregar apenas uma demo de chat.
Ao comparar propostas, peça que o parceiro demonstre cinco situações: duas fontes conflitantes, um claim expirado, uma correção urgente, uma pergunta sem resposta e uma variante para outro mercado. Observe se o sistema cita a origem, respeita filtro, abstém, atualiza dependências e registra a decisão. Essa prova apoia o projeto; não precisa virar outro processo genérico de seleção.
Leve o conhecimento problemático para a primeira conversa
Use o plano inicial em https://makinai.co/insights/pt/por-onde-comecar-ia-marketing-plano-90-dias, conecte a camada ao fluxo em https://makinai.co/insights/pt/ia-fluxo-producao-campanhas-briefing-lancamento e avalie pré-requisitos em https://makinai.co/insights/pt/avaliar-prontidao-dados-antes-contratar-empresa-ia. Para tornar a mesma evidência publicável e encontrável, veja https://makinai.co/insights/pt/empresa-google-nao-respostas-ia-plano-geo. A MAKINAI implementa arquitetura de dados, conteúdo e inteligência: https://makinai.co/services/pt/dados-conteudo-inteligencia-artificial. Traga dez perguntas que geram respostas divergentes e as fontes usadas hoje; podemos delimitar o primeiro fluxo.
As fontes sustentam componentes de recuperação, etapas de RAG, proveniência e gestão de risco. Elas não provam que uma camada específica reduzirá retrabalho ou aumentará receita. O contrato, o escopo, as métricas e os trade-offs são recomendações editoriais da MAKINAI e precisam ser validados com conteúdo, sistemas e usuários reais.